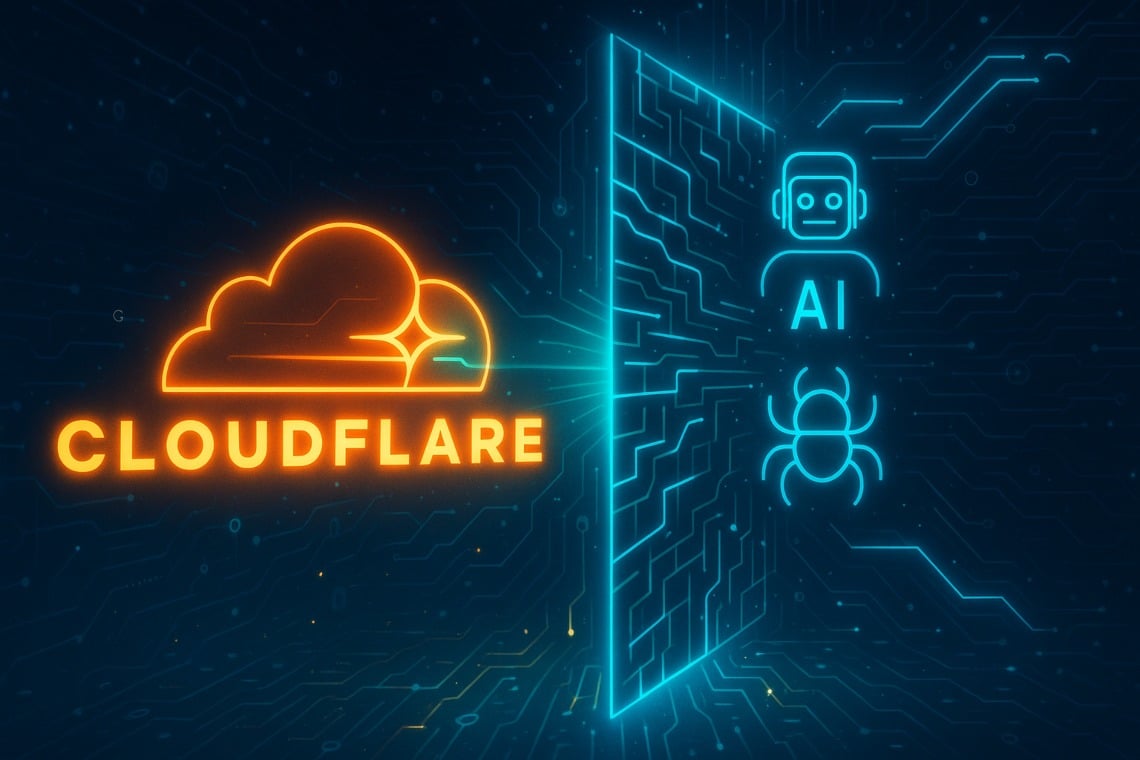
Van Cloudflare komt een historische wending: de gigant van de internetinfrastructuur blokkeert de belangrijkste crawler AI om online inhoud te beschermen. Deze beslissing herdefinieert het evenwicht tussen makers, technologiebedrijven en consumenten, met de belofte om het beheer en de bescherming van gegevens op het web te revolutioneren.
Inhoudsopgave
Strijd tegen AI-crawlers: de beslissing van Cloudflare
Cloudflare heeft op 1 juli een offensief gestart tegen de belangrijkste kunstmatige intelligentie bedrijven die gegevens van websites verzamelen zonder toestemming. Zoals verklaard door het bedrijf zelf, zullen de AI crawlers standaard worden geblokkeerd op alle nieuwe sites die Cloudflare gebruiken, tenzij de eigenaren expliciete toestemming geven. In het verleden moesten de sitebeheerders actief de AI-bots uitsluiten van het verzamelen van hun gegevens.
Deze omkering van logica beschermt meer dan 20% van het web, het aandeel dat wordt gedekt door Cloudflare-klanten, en reageert op de toenemende meldingen van vertragingen en storingen veroorzaakt door buitengewone stromen van geautomatiseerde verzoeken afkomstig van bots van grote namen in de AI zoals GPTBot van OpenAI en ClaudeBot van Anthropic.
Impact van AI-crawlers: de cijfers van het fenomeen
Het verkeer gegenereerd door de AI crawling bots heeft indrukwekkende niveaus bereikt. Bijvoorbeeld, GoogleBot heeft vastgesteld dat Vercel, een cloud-hostingdienst, meer dan 4,5 miljard verzoeken per maand ontvangt van deze software. In tegenstelling tot de normale zoekmachine crawlers, behandelen de AI-bots de servers agressief, door meerdere keren dezelfde pagina’s binnen enkele uren te bezoeken of door de sites te bombarderen met honderden verzoeken per seconde.
Het resultaat? Langzamere sites, toegangsmoeilijkheden voor echte gebruikers en een wijdverspreid gevoel van het onderwerp zijn van een ware “extractie” van inhoud zonder regels of compensatie. Talrijke uitgevers en bedrijven, van The Associated Press tot Condé Nast en Ziff Davis, hebben de praktijk van massale en ongeautoriseerde verzameling door de big tech van AI aan de kaak gesteld.
Nieuwe regels en technologieën om de inhoud te verdedigen
De zet van Cloudflare beperkt zich niet tot een oppervlakkig verbod. Het bedrijf heeft namelijk de inzet van machine learning en gedragsanalyse aangekondigd om ook de zogenaamde “shadow scrapers” op te sporen, vermomde bots die proberen de conventionele blokkades te omzeilen. Op deze manier zullen niet alleen de verklaarde crawlers, maar ook de meer geavanceerde pogingen tot scraping worden onderschept.
Bovendien moeten AI-leveranciers nu toestemming vragen voordat ze toegang kunnen krijgen tot de gegevens, waarbij ze duidelijk de gebruiksdoelen aangeven, zowel voor het trainen van algoritmen als voor eenvoudige zoekfuncties. Cloudflare geeft zo de uitgevers de mogelijkheid terug om te beslissen wie met hun informatie kan omgaan.
De protesten van de belangrijkste uitgeversgroepen hebben de geboorte van dit nieuwe beleid bevorderd. De huidige uitsluitingssystemen, zoals de traditionele robots.txt, worden vaak genegeerd door AI-bots, die de neiging hebben om het web te “delven” zonder de regels voor respect voor digitale intellectuele eigendom te volgen.
Pay Per Crawl: naar een nieuw economisch model voor de inhoud
De revolutie ondertekend door Cloudflare introduceert ook een andere nieuwigheid: het programma Pay Per Crawl. Dit systeem, dat zich momenteel in een private bètafase bevindt, stelt uitgevers in staat om toegangsprijzen vast te stellen voor degenen die hun inhoud willen gebruiken voor AI-training. Toegang wordt alleen verleend na betaling, of anders geweigerd.
Vanuit technisch oogpunt zal Cloudflare gebruikmaken van de code HTTP 402 “Payment Required”, die wordt teruggegeven aan niet-geautoriseerde crawlers. Een potentieel effectieve oplossing, al klaar voor implementatie dankzij de compatibiliteit met bestaande websystemen.
De reacties uit de AI-wereld en de regelgevende knelpunten
De beslissing van Cloudflare beïnvloedt direct de AI-bedrijven, die tot nu toe terughoudend waren om licenties of vergoedingen te betalen. Nicholas Thompson, CEO van The Atlantic, benadrukte hoe bedrijven tot nu toe straffeloos konden handelen, terwijl ze nu moeten onderhandelen en de eigendom van de inhoud moeten erkennen. Aan de andere kant waarschuwen sommige leiders uit de technologische wereld, zoals Nick Clegg van Meta, dat de introductie van strikte beperkingen de groei en innovatie in de AI-sector in gevaar zou kunnen brengen.
Het debat strekt zich ook uit tot het regelgevingsniveau. Een rapport van de Copyright Office heeft erkend dat bepaalde toepassingen van generatieve technologieën “transformatief” kunnen zijn. Desalniettemin kan massale verzameling zonder toestemming niet als fair use worden beschouwd. Een standpunt dat zware institutionele gevolgen heeft gehad, inclusief de onmiddellijke vervanging van de verantwoordelijke van het Bureau voor Intellectuele Eigendom door de Trump-administratie.
De toekomst van de bescherming van online inhoud
Het initiatief van Cloudflare hertekent de evenwichten tussen degenen die online inhoud creëren en degenen die deze exploiteren. De mogelijkheid om de toegang tot gegevens te blokkeren en te monetariseren biedt uitgevers een reële macht over waar en hoe hun werken worden gebruikt. Als gevolg hiervan zullen veel AI-bedrijven hun strategieën en gegevensverwervingsprocessen moeten herzien, wat zal leiden tot meer transparantie en samenwerking met de uitgeverswereld.
Terwijl het digitale ecosysteem zich aanpast aan deze paradigmaverschuiving, is het waarschijnlijk dat andere grote spelers in de infrastructuursector het voorbeeld van Cloudflare zullen volgen. Op deze manier kan een nieuw tijdperk worden ingeluid in de verdediging van digitale rechten, waar degenen die waarde creëren worden gestimuleerd en beschermd. De vragen over de timing en de manier van adoptie van het Pay Per Crawl-model en de effecten die het zal hebben op de ontwikkeling van kunstmatige intelligentie blijven open.
In een voortdurend veranderende context wordt het monitoren van de evolutie van de strategieën anti-crawler AI en actief deelnemen aan het debat essentieel voor alle betrokken partijen. De oorlog tegen ongeautoriseerde bots zou slechts het begin kunnen zijn van een nieuw seizoen voor de waardering van het web als een collectief en duurzaam goed.